KI-Transkriptionssoftware mit Ollama oder LM Studio
Verbinden Sie die KI Recherche von TrueScribe mit einem Modell auf Ihrem Rechner, über Ollama oder LM Studio, passend zu Ihrem Arbeitsspeicher.
Veröffentlicht
TrueScribe ist eine Transkriptionssoftware, die Whisper auf Ihrem Windows- oder Linux-Rechner ausführt. Die KI Recherche beantwortet Fragen zu einem Transkript, und das Sprachmodell dahinter kann auf demselben Rechner laufen. Installieren Sie Ollama oder LM Studio, laden Sie ein Modell herunter, und TrueScribe findet beides von selbst. Mit einem lokalen Modell verlässt das Transkript Ihr Gerät nicht, und die KI Recherche gehört zur kostenlosen Version.
Die Einrichtung hat drei Teile. Sie wählen ein Modell, das zu Ihrer Hardware passt, installieren eine Laufzeitumgebung mit diesem Modell und verbinden es in TrueScribe.
Ein Modell für Ihren Rechner wählen
Ein Sprachmodell muss in den Speicher passen. Am schnellsten antwortet es auf einer Grafikkarte mit eigenem Speicher. Ohne eine solche Karte läuft das Modell auf dem Prozessor aus dem Arbeitsspeicher und antwortet langsamer. Sehen Sie deshalb zuerst beide Werte nach:
- Unter Windows öffnen Sie den Task-Manager, wählen Leistung und lesen die Größe unter Arbeitsspeicher ab. Unter GPU steht bei Dedizierter GPU-Speicher der eigene Speicher der Grafikkarte.
- Unter Linux zeigt
free -him Terminal den Arbeitsspeicher. Bei einer NVIDIA-Karte zeigtnvidia-smiden Grafikspeicher.
Wählen Sie dann ein Modell, dessen Download deutlich kleiner ist als dieser Speicher, denn System, TrueScribe und Whisper brauchen ebenfalls Platz. Die Tabelle gibt Ausgangspunkte:
| Ihr Rechner | Ollama-Modell | Download |
|---|---|---|
| 8 GB Arbeitsspeicher, keine Grafikkarte mit eigenem Speicher | llama3.2:3b |
2,0 GB |
| Ab 16 GB Arbeitsspeicher ohne eine solche Karte, oder Karte mit 8 GB | gemma4:e4b |
6,6 GB |
| Eine Grafikkarte mit 12 bis 16 GB, etwa eine RTX 4080 | gemma4:12b |
7,7 GB |
| Eine Grafikkarte mit 24 GB | gemma4:26b |
16 GB |
Die Downloadgrößen stammen aus der Ollama-Bibliothek, Stand Oktober 2026. llama3.2:3b schlägt TrueScribe vor, solange Ollama noch kein Modell hat. gemma4:e4b ist klein genug für den Prozessor allein. Behalten Sie es deshalb neben einem größeren Modell als Ausweichmodell, falls die Grafikkarte ausfällt. Antwortet das Modell zu langsam, gehen Sie eine Zeile nach oben zu einem kleineren Modell. Gemma 4 denkt nach, bevor es antwortet. Auf dem Prozessor allein dauert es deshalb eine Weile, bis die ersten Wörter erscheinen.
Weg 1: Ollama installieren
Ollama ist eine kostenlose, quelloffene Laufzeitumgebung, die Modelle im Hintergrund bereitstellt. TrueScribe empfiehlt sie.
Unter Windows
Laden Sie OllamaSetup.exe von ollama.com/download herunter und starten Sie die Datei, oder installieren Sie Ollama im Terminal mit dem Befehl, den TrueScribe anzeigt:
winget install Ollama.Ollama
Für die Installation brauchen Sie keine Administratorrechte. Danach läuft Ollama im Hintergrund, und der Befehl ollama funktioniert in der Eingabeaufforderung und in PowerShell. Laut Ollamas Windows-Dokumentation braucht Ollama Windows 10 22H2 oder neuer. NVIDIA-Karten brauchen den Treiber 551.61 oder neuer, AMD-Radeon-Karten laufen über ROCm oder Vulkan.
Unter Linux
Führen Sie das Installationsskript aus Ollamas Linux-Dokumentation aus:
curl -fsSL https://ollama.com/install.sh | sh
Ob Ollama läuft, zeigt ollama -v. Meldet der Befehl keine laufende Instanz, starten Sie Ollama mit ollama serve.
Das Modell herunterladen
Laden Sie das Modell aus Ihrer Tabellenzeile herunter. Auf einem Rechner mit einer 16-GB-Grafikkarte holen Sie zum Beispiel das Modell für die Karte und das Ausweichmodell für den Prozessor:
ollama pull gemma4:12b
ollama pull gemma4:e4b
ollama list zeigt alle heruntergeladenen Modelle. Hat TrueScribe das Modell einmal benutzt, zeigt ollama ps, wo es geladen ist. 100% GPU bedeutet Grafikkarte, 100% CPU bedeutet Arbeitsspeicher, und eine Aufteilung bedeutet, dass das Modell nicht ganz auf die Karte gepasst hat. Die Ollama-FAQ erklärt die Spalte.
Weg 2: LM Studio installieren
LM Studio ist eine Desktop-App zum Herunterladen und Ausführen von Modellen, mit eigener Modellsuche. Sie bekommen sie auf lmstudio.ai. Die Windows-Version läuft auf x64 und ARM, die Linux-Version ist ein AppImage. Die Systemanforderungen von LM Studio verlangen einen Prozessor mit AVX2 und empfehlen 16 GB Arbeitsspeicher und 4 GB Grafikspeicher.
Jeden Schritt im Detail, mit den Servereinstellungen und auf echter Hardware gemessenen Geschwindigkeiten, beschreibt Transkriptionssoftware mit lokalem LLM in LM Studio.
- Öffnen Sie mit Strg+2 den Tab Discover und suchen Sie das Modell aus Ihrer Tabellenzeile, mit Leerzeichen geschrieben, etwa
gemma 4 12b. - Wählen Sie eine Download-Variante mit 4 Bit (Q4) oder mehr, wie es die Download-Anleitung von LM Studio empfiehlt.
- Öffnen Sie den Tab Developer und schalten Sie Start server ein. Im Terminal geht das laut Server-Dokumentation auch mit
lms server start. - Lassen Sie den Port bei 1234, denn dort sucht TrueScribe nach LM Studio. Lassen Sie Require Authentication ausgeschaltet, weil TrueScribe einer Laufzeitumgebung auf Ihrem eigenen Rechner keinen Schlüssel schickt.
Lassen Sie in den Servereinstellungen Just in Time Model Loading eingeschaltet. Dann meldet LM Studio alle heruntergeladenen Modelle an TrueScribe und lädt das Modell, das Sie benutzen. Ist die Option aus, laden Sie das Modell zuerst in LM Studio.
Das Modell in TrueScribe verbinden
-
Öffnen Sie ein Transkript und wechseln Sie zur KI Recherche (Alt+2). Solange kein Modell eingerichtet ist, zeigt sie die Schaltfläche KI einrichten…. Alternativ wählen Sie Einstellungen, dann KI Recherche und Modell hinzufügen.
-
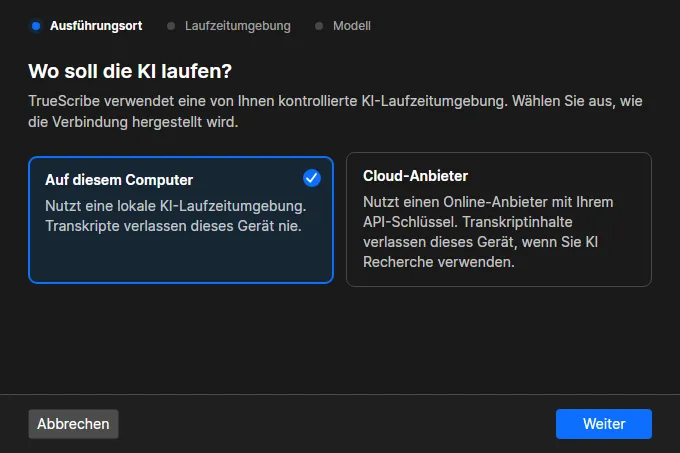
Wählen Sie Auf diesem Computer und Weiter.
-
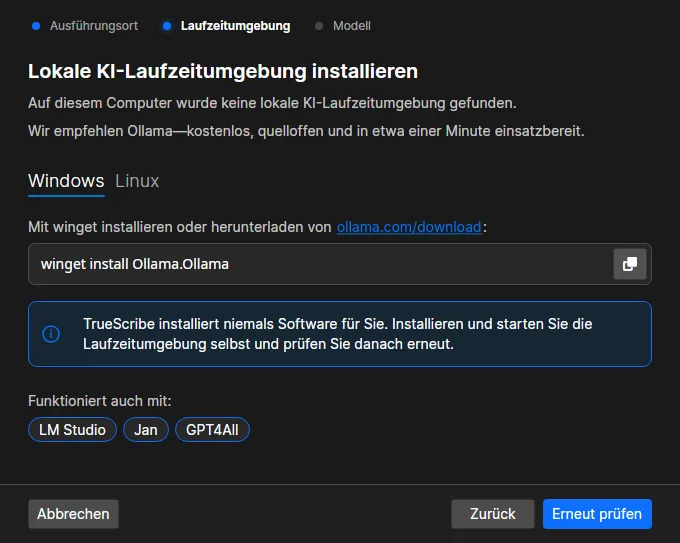
TrueScribe sucht auf diesem Rechner nach Ollama, LM Studio, Jan und GPT4All. Findet es nichts, zeigt es die Installationsbefehle für Ollama unter Windows und Linux. TrueScribe installiert selbst nie Software. Installieren Sie eine Laufzeitumgebung und wählen Sie dann Erneut prüfen.
-
Hat die Laufzeitumgebung noch kein Modell, sagt TrueScribe das. Für Ollama zeigt es den Befehl
ollama pull llama3.2:3bmit einer Kopierschaltfläche. Haben Sie in der Tabelle ein größeres Modell gewählt, laden Sie stattdessen dieses. Für LM Studio bittet es Sie, ein Modell direkt in LM Studio herunterzuladen. Wählen Sie Erneut prüfen, wenn der Download fertig ist.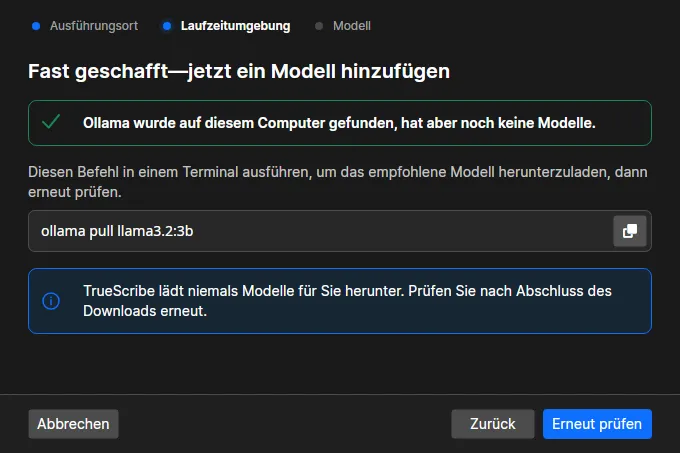
-
Wählen Sie ein Modell. Die Liste zeigt die Modelle aller gefundenen Laufzeitumgebungen, markiert eines als Empfohlen und kennzeichnet Embedding-Modelle mit Nicht für KI Recherche geeignet. Wählen Sie Fertigstellen. TrueScribe prüft, ob das Modell antwortet, bevor es die Auswahl speichert.
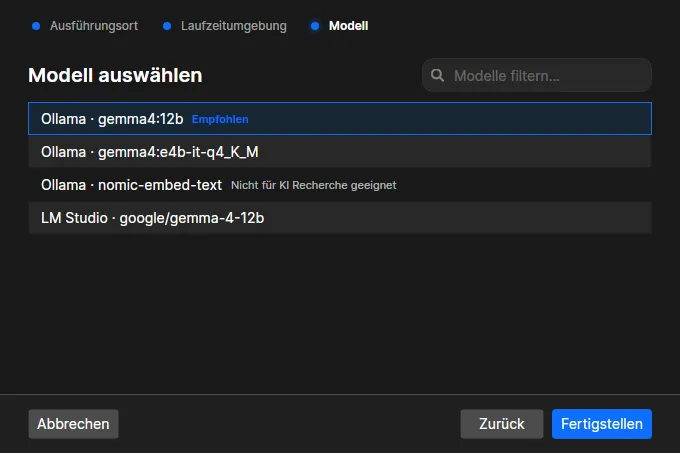
Um zusätzlich das Ausweichmodell einzurichten, wählen Sie Einstellungen, dann KI Recherche und Modell hinzufügen und wählen es in derselben Liste.
Fragen zum Transkript stellen
Schreiben Sie eine Frage unter das Transkript und drücken Sie die Eingabetaste. Die Antwort erscheint mit dem Namen des Modells, das sie geschrieben hat. Mit der Auswahl im Eingabefeld wechseln Sie für die nächste Nachricht zu einem anderen eingerichteten Modell.
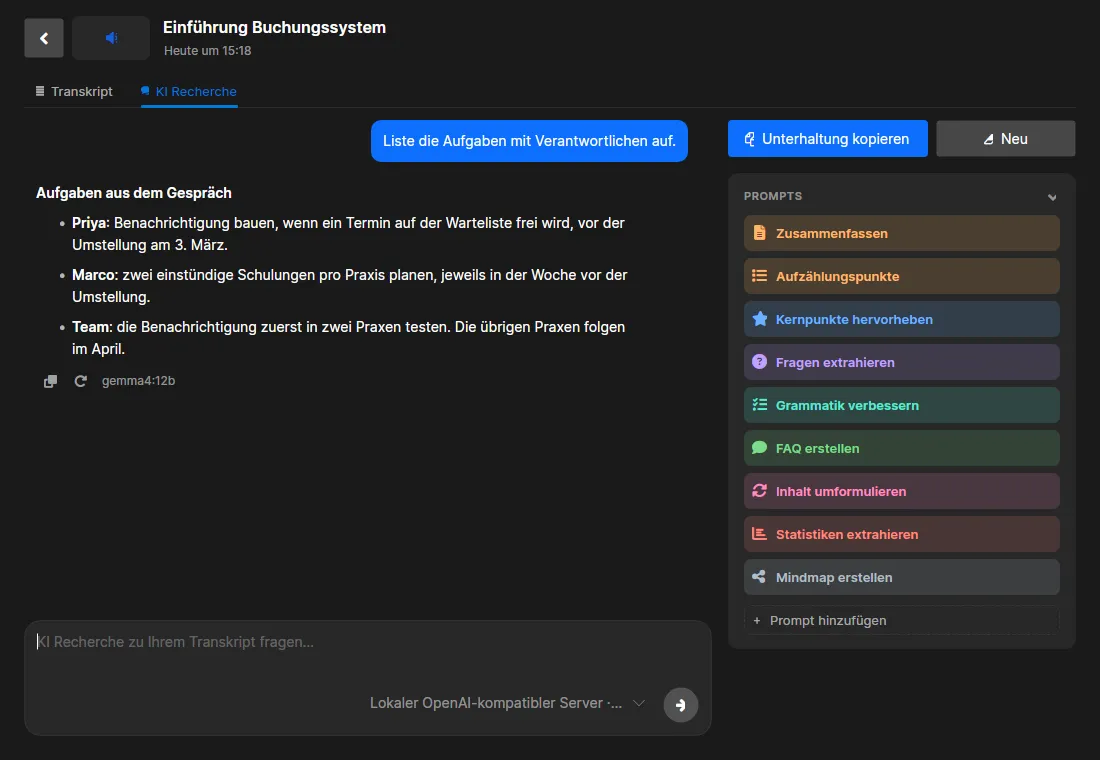
Eigene Fragen sind kostenlos. Pro ergänzt Zusammenfassungen mit einem Klick, kuratierte und wiederverwendbare eigene Prompts sowie automatische Meeting-Zusammenfassungen und Titel mit dem Modell Ihrer Wahl. Ein kleines lokales Modell übersieht manchmal Details oder verwechselt, wer was gesagt hat. Prüfen Sie Antworten deshalb am Transkript, bevor Sie sie verwenden.
Wenn etwas nicht funktioniert
- TrueScribe findet Ollama nicht. Unter Windows muss Ollama nach der Installation im Hintergrund laufen. Unter Linux zeigt
ollama -v, ob der Server läuft. - TrueScribe findet LM Studio nicht. Start server im Tab Developer muss eingeschaltet sein, mit Port 1234.
- Die Antworten kommen langsam. Wählen Sie ein kleineres Modell, oder prüfen Sie mit
ollama ps, ob das Modell zwischen Prozessor und Grafikkarte aufgeteilt ist. - Die Grafikkarte steht nicht zur Verfügung. Wählen Sie in der Auswahl im Eingabefeld das Ausweichmodell, etwa
gemma4:e4b. - Sie arbeiten mit langen Transkripten. Ollama gibt Modellen einen Kontext von 4k Token, wenn die Grafikkarte weniger als 24 GB hat. Mit einem größeren Kontext in den Ollama-Einstellungen liest das Modell mehr von einem langen Transkript auf einmal und braucht mehr Speicher.
Grenzen
- TrueScribe installiert weder Ollama noch LM Studio und lädt keine Sprachmodelle herunter. Beides erledigen Sie selbst.
- Die Suche umfasst nur diesen Rechner.
- Verbinden Sie stattdessen einen Cloud-Anbieter, verlassen die Inhalte, die für eine Antwort nötig sind, Ihr Gerät.
- TrueScribe läuft unter Windows und Linux. Eine macOS-Version gibt es nicht.
Wie TrueScribe im Vergleich zu anderer Transkriptionssoftware abschneidet, zeigt Transkriptionssoftware für Windows und Linux: 7 im Test. Meeting-Transkriptionssoftware für Zoom, Teams und Meet zeigt, wo automatische Zusammenfassungen mit Ihrem lokalen Modell ins Spiel kommen.
Laden Sie TrueScribe herunter oder sehen Sie sich an, was Pro enthält.